
NVIDIA تشغّل GLM-5.3 عبر محطتي DGX باستخدام vLLM
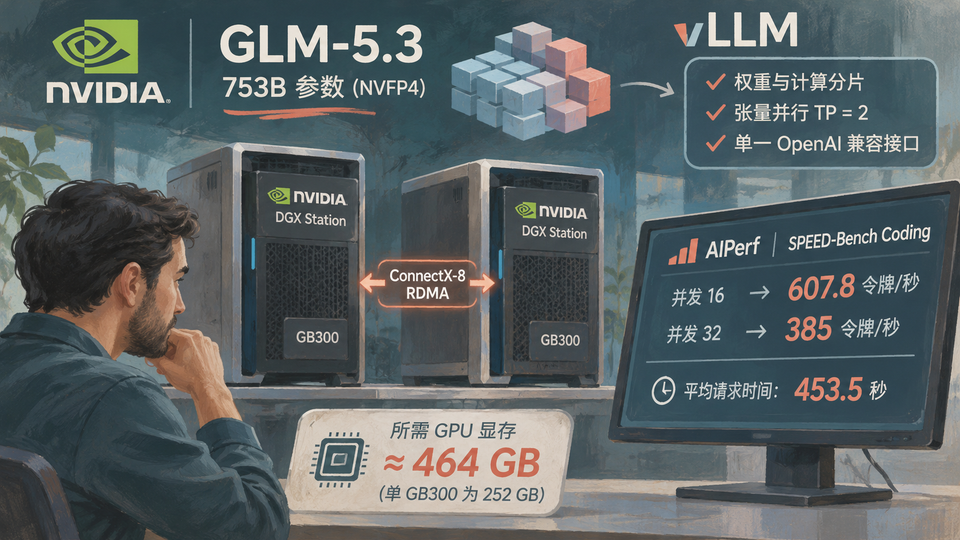
عرضت NVIDIA تشغيل نموذج GLM-5.3 NVFP4، المؤلف من 753 مليار معلَمة، على محطتي NVIDIA DGX Station متصلتين عبر ConnectX-8 RDMA. ويقسّم vLLM الأوزان والحوسبة بين وحدتي GB300 بتوازي موتر TP=2، مقدماً واجهة واحدة متوافقة مع OpenAI.
عرضت NVIDIA تشغيل نموذج GLM-5.3 NVFP4، المؤلف من 753 مليار معلَمة، على محطتي NVIDIA DGX Station متصلتين عبر ConnectX-8 RDMA. ويقسّم vLLM الأوزان والحوسبة بين وحدتي GB300 بتوازي موتر TP=2، مقدماً واجهة واحدة متوافقة مع OpenAI.
يحتاج النموذج إلى نحو 464 غيغابايت من ذاكرة GPU، متجاوزاً 252 غيغابايت في وحدة GB300 واحدة. وفي اختبارات AIPerf على SPEED-Bench Coding، بلغ إجمالي الإنتاجية 607.8 رمزاً في الثانية عند تزامن 16، قبل أن ينخفض إلى 385 رمزاً عند تزامن 32، مع متوسط زمن طلب 453.5 ثانية.
When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM · تاريخ النشر في المصدر: