
تقرير METR: تقدم سريع للذكاء الاصطناعي مع ضعف في مهام الحكم
أظهر تحديث لتقرير METR أن نماذج الذكاء الاصطناعي تواصل التحسن بسرعة في المهام القابلة للتحقق، إذ كانت مدة المهام التي تنجح فيها النماذج الرائدة تتضاعف كل أربعة أشهر. لكن النماذج بقيت دون الأداء البشري في مهام مفتوحة تتطلب حكماً، مثل تصميم تقييمات للذكاء الاصطناعي وتقدير الحجج الفلسفية.
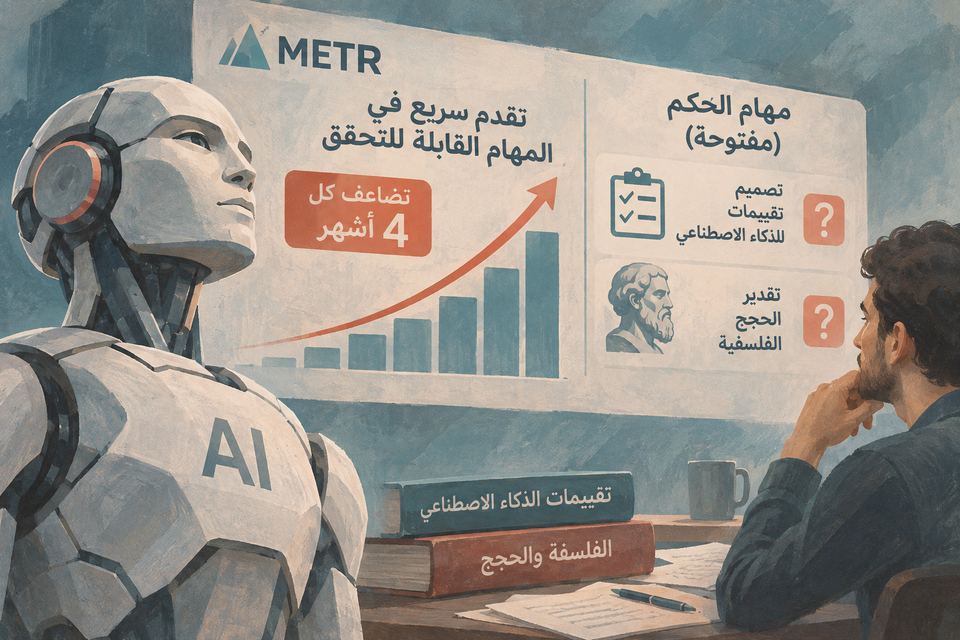
أظهر تحديث لتقرير METR أن نماذج الذكاء الاصطناعي تواصل التحسن بسرعة في المهام القابلة للتحقق، إذ كانت مدة المهام التي تنجح فيها النماذج الرائدة تتضاعف كل أربعة أشهر. لكن النماذج بقيت دون الأداء البشري في مهام مفتوحة تتطلب حكماً، مثل تصميم تقييمات للذكاء الاصطناعي وتقدير الحجج الفلسفية.
تكتسب النتائج أهمية لأن هذه المهام أقرب إلى ما يلزم لأتمتة البحث والتطوير في الذكاء الاصطناعي. وسجلت نماذج أحدث، بينها Opus 5.5، أداء «فوق العتبة بصورة هامشية» في تصميم التقييمات، بعد أن كانت جميع النماذج قبل عام «دون العتبة بوضوح». إلا أن METR تؤكد صعوبة قياس هذه المهام وتوقع مسار التقدم فيها بسبب محدودية التقييمات وتقديرات زمن إنجاز البشر لها.
The most misunderstood graph in AI just got a major update · تاريخ النشر في المصدر: