
تقنيات Tensor Core تسرّع محاكاة الذرات بالذكاء الاصطناعي دون إعادة تدريب
أظهرت NVIDIA أن BF16x9 على معالجات Blackwell سرّعت عمليات GEMM الكبيرة في نموذج Point Edge Transformer حتى 2.5 مرة، وخطوة الديناميكيات الجزيئية حتى 1.7 مرة، من دون تعديل بنية النموذج أو إعادة تدريبه.
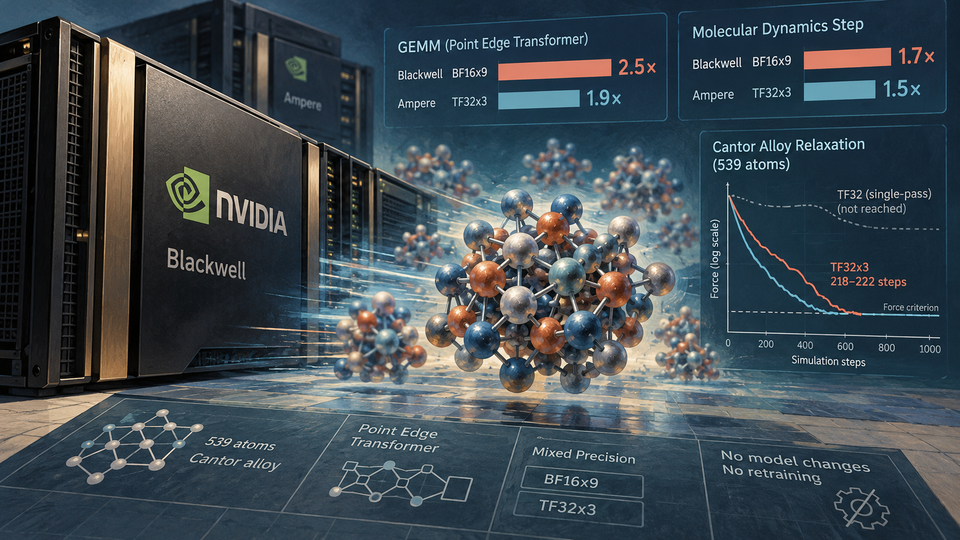
أظهرت NVIDIA أن BF16x9 على معالجات Blackwell سرّعت عمليات GEMM الكبيرة في نموذج Point Edge Transformer حتى 2.5 مرة، وخطوة الديناميكيات الجزيئية حتى 1.7 مرة، من دون تعديل بنية النموذج أو إعادة تدريبه.
وعلى معالجات Ampere، سرّعت TF32x3 عمليات GEMM حتى 1.9 مرة وخطوة المحاكاة حتى 1.5 مرة مع سلوك قريب من FP32. وفي اختبار استرخاء سبيكة Cantor من 539 ذرة، وصلت TF32x3 إلى معيار القوة خلال 218–222 خطوة، بينما أخفقت TF32 أحادية المرور في بلوغه حتى بعد 1000 خطوة. وتدعم النتائج استخدام الدقة المختلطة لتوسيع محاكاة المواد والجزيئات مع الحفاظ على الاستقرار العددي.
Unlocking Tensor Core Performance for Machine Learning Interatomic Potentials · تاريخ النشر في المصدر: