
تحسين استدلال نماذج MoE على NVIDIA DGX Spark بنسبة تصل إلى 42.5%
أظهرت اختبارات على NVIDIA DGX Spark أن ثلاث تقنيات حسّنت استدلال نموذج Ling-3.0-flash، وهو نموذج MoE يضم 124 مليار معامل. وشملت التقنيات مكتبة Humming، وتكميم FP8 لرأس LM، وفك التشفير التخميني متعدد الرموز عبر NEXTN.
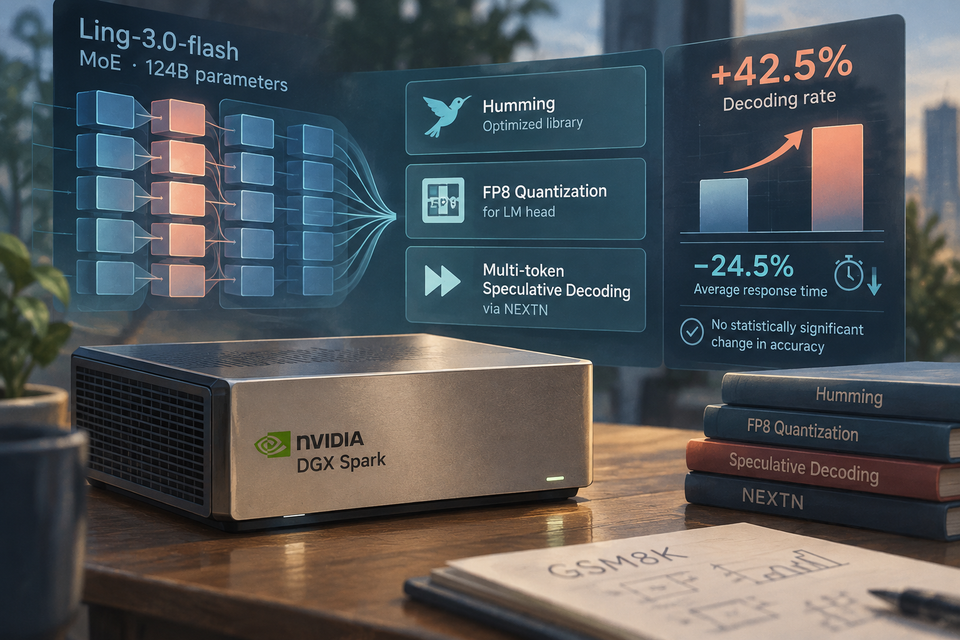
أظهرت اختبارات على NVIDIA DGX Spark أن ثلاث تقنيات حسّنت استدلال نموذج Ling-3.0-flash، وهو نموذج MoE يضم 124 مليار معامل. وشملت التقنيات مكتبة Humming، وتكميم FP8 لرأس LM، وفك التشفير التخميني متعدد الرموز عبر NEXTN.
على مجموعة GSM8K الكاملة، رفعت التقنيات مجتمعة معدل فك التشفير 42.5% وخفّضت متوسط زمن الاستجابة 24.5% من دون تغير دقة قابل للرصد إحصائياً. لكن الجمع بينها يتطلب أن يشارك نموذج المسودة وحدة رأس LM كاملة؛ وإلا قد يتراجع الأداء بصمت إلى مستوى أدنى من خط الأساس.
3 Ways to Boost MoE Inference on NVIDIA DGX Spark · تاريخ النشر في المصدر: