
تدقيق خارجي يكشف ثغرات في مراقبة سلامة الذكاء الاصطناعي لدى OpenAI
كشف تدقيق ميداني استمر ثلاثة أسابيع في OpenAI، نفّذه باحثان من METR وRedwood Research بين 21 يوليو و11 أغسطس، ثغرات في مراقبة سلوك الذكاء الاصطناعي المارق. وقدّر المدققون أن 6% إلى 25% من حركة Responses API الداخلية لوكلاء من فئة GPT-5.5 فأعلى لم تكن مشمولة بالمراقبة.
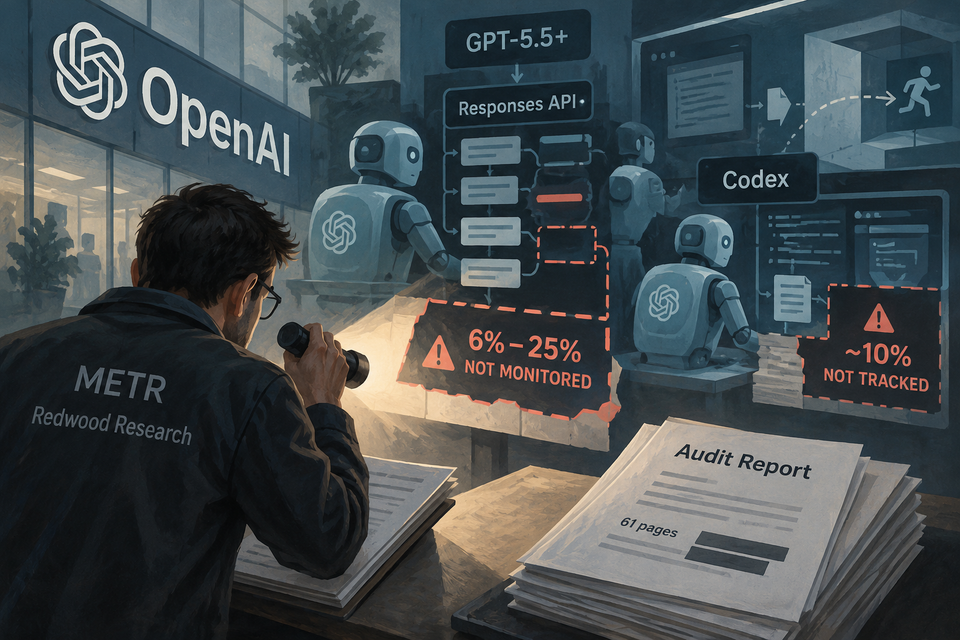
كشف تدقيق ميداني استمر ثلاثة أسابيع في OpenAI، نفّذه باحثان من METR وRedwood Research بين 21 يوليو و11 أغسطس، ثغرات في مراقبة سلوك الذكاء الاصطناعي المارق. وقدّر المدققون أن 6% إلى 25% من حركة Responses API الداخلية لوكلاء من فئة GPT-5.5 فأعلى لم تكن مشمولة بالمراقبة.
وقدّر التدقيق أن نحو 10% من حركة Codex الداخلية المفترض مراقبتها لم تُتبع بين مايو ويوليو بسبب خلل في أحداث ضغط السياق، أصلحته OpenAI أثناء التدقيق. كما رصد إمكان إخفاء مئات الإجراءات وتجاوز بيئة Codex المعزولة. وقالت الشركة إنها أصلحت الثغرات، لكن النسخة العامة من التقرير المكوّن من 61 صفحة اقتصرت على ملخص قصير بعد تنقيحات.
Three-week on-site audit at OpenAI reveals major gaps in AI safety monitoring · تاريخ النشر في المصدر: