
إرشادات لتحجيم وحدات GPU لخفض كلفة استدلال الذكاء الاصطناعي
يطرح الدليل إطاراً لتحجيم وحدات GPU لاستدلال الذكاء الاصطناعي وفق نوع التطبيق، واختيار النموذج، والمستخدمين النشطين يومياً، والتزامن، وأطوال المدخلات والمخرجات، ومعدل إصابة الذاكرة المخبأة وأهداف زمن الاستجابة. ويقترح نموذج «الأساس والمرونة» للجمع بين السعات الثابتة والسحابية المرنة.
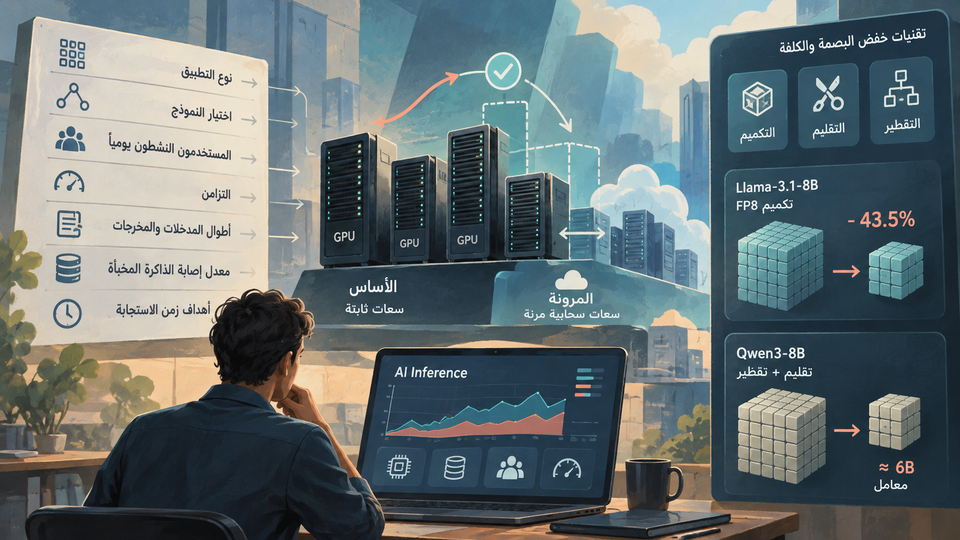
يطرح الدليل إطاراً لتحجيم وحدات GPU لاستدلال الذكاء الاصطناعي وفق نوع التطبيق، واختيار النموذج، والمستخدمين النشطين يومياً، والتزامن، وأطوال المدخلات والمخرجات، ومعدل إصابة الذاكرة المخبأة وأهداف زمن الاستجابة. ويقترح نموذج «الأساس والمرونة» للجمع بين السعات الثابتة والسحابية المرنة.
يركز الإطار على مواءمة ذاكرة وقدرة GPU مع الحمل لتفادي الهدر أو تقييد الإنتاجية. كما يشير إلى أن التكميم والتقليم والتقطير تخفض البصمة والكلفة؛ إذ خفّض تكميم FP8 عبر NVIDIA Model Optimizer ذاكرة أوزان Llama-3.1-8B بنسبة 43.5% من دون إعادة تدريب، فيما أنتج تقليم Qwen3-8B مع التقطير نموذجاً بنحو 6 مليارات معامل.
How to Size GPUs for AI Inference and TCO Without Overspending · تاريخ النشر في المصدر: