
Nvidia تطور GR00T 2 لتعليم الروبوتات من فيديوهات البشر
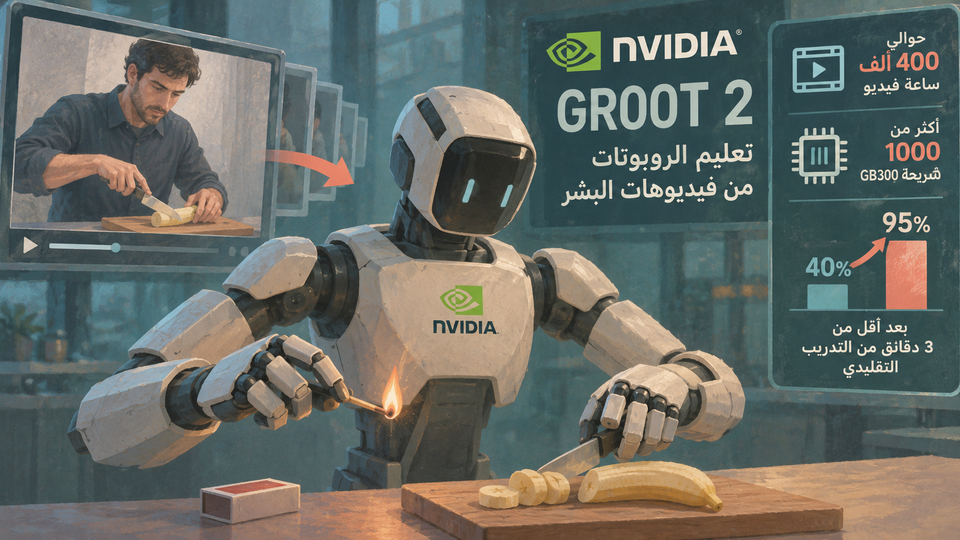
كشفت Nvidia عن نموذج الذكاء الاصطناعي GR00T 2، الذي ينقل حركات البشر من الفيديو إلى أذرع روبوتية عبر توقع الحركة التالية ومشهد الفيديو القريب. دُرّب على نحو 400 ألف ساعة من الفيديو باستخدام أكثر من ألف شريحة GB300، ونجح في مهام منها إشعال عود ثقاب وتقطيع موزة.
كشفت Nvidia عن نموذج الذكاء الاصطناعي GR00T 2، الذي ينقل حركات البشر من الفيديو إلى أذرع روبوتية عبر توقع الحركة التالية ومشهد الفيديو القريب. دُرّب على نحو 400 ألف ساعة من الفيديو باستخدام أكثر من ألف شريحة GB300، ونجح في مهام منها إشعال عود ثقاب وتقطيع موزة.
يهدف النموذج إلى خفض الاعتماد على التشغيل عن بُعد المكلف والبطيء عند تدريب الروبوتات. تراوحت نسب النجاح بين 10% و80%، ورفعت أقل من ثلاث دقائق من التدريب التقليدي النجاح من 40% إلى 95% في 50 مهمة مختارة. لكنه لا يعالج بيانات اللمس مباشرة، وقد يفوّت أخطاء دقيقة، كما يبطئه نموذج لغوي أعلى مستوى في بعض المهام.
Nvidia's model GR00T 2 watches humans on video, then imagines itself as the robot · تاريخ النشر في المصدر: