
NVIDIA تطرح إرشادات لتسريع الاستدلال طويل السياق بالانتباه المتناثر
عرضت NVIDIA تصميماً مشتركاً للانتباه المتناثر يهدف إلى خفض كلفة الاستدلال في النماذج ذات السياقات الطويلة. وتوصي باستخدام KH=1، وأبعاد رؤوس 128 أو 256، ودمج Top-k مع الفهرس، والاعتماد على FP16، واختيار كتل كبيرة للانتباه الأساسي.
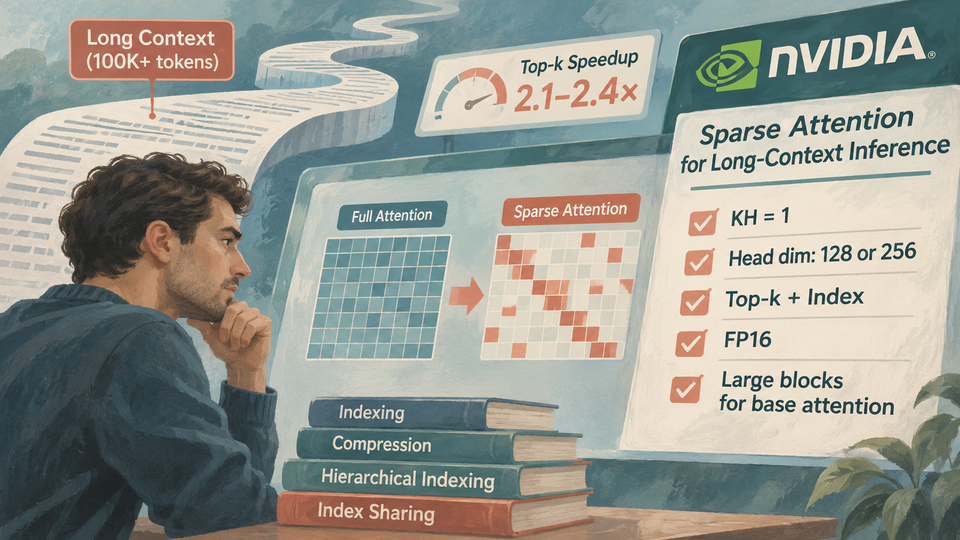
عرضت NVIDIA تصميماً مشتركاً للانتباه المتناثر يهدف إلى خفض كلفة الاستدلال في النماذج ذات السياقات الطويلة. وتوصي باستخدام KH=1، وأبعاد رؤوس 128 أو 256، ودمج Top-k مع الفهرس، والاعتماد على FP16، واختيار كتل كبيرة للانتباه الأساسي.
تزداد أهمية هذه الإرشادات مع انتقال السياقات من عشرات آلاف الرموز إلى مئات الآلاف، حيث يبقى الفهرس مضطراً إلى تقييم كامل السياق رغم تقليل الانتباه الأساسي. وقالت القياسات إن إعادة استخدام اختيار الخطوة السابقة تسرّع Top-k بين 2.1 و2.4 مرة، فيما يقلل الضغط والفهرسة الهرمية ومشاركة الفهرس العمل في مرحلتي الفهرسة والاختيار.
Co-Designing Sparse Attention for Efficient Long-Context Inference · تاريخ النشر في المصدر: