
اختبار واقعي يكشف حاجة وكلاء البرمجة بالذكاء الاصطناعي إلى تدخل بشري
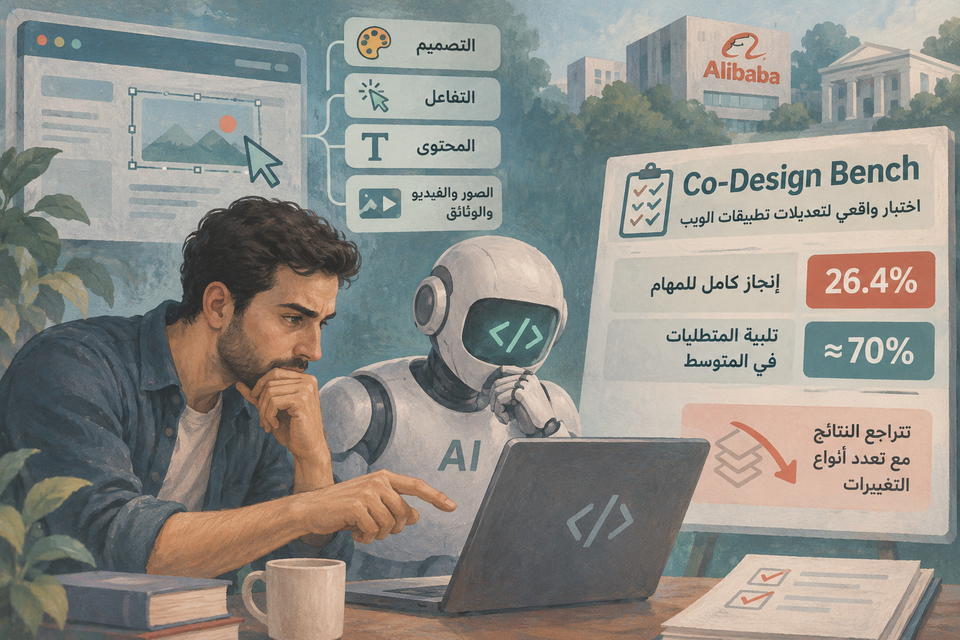
أظهر معيار Co-Design Bench، الذي طوّره باحثون من Alibaba وجامعات آسيوية اعتماداً على طلبات تغيير حقيقية لتطبيقات ويب، أن GPT-6 Astra، الأفضل بين 10 نماذج، ينجز بالكامل 26.4% فقط من المهام، رغم تلبيته نحو 70% من متطلباتها في المتوسط.
أظهر معيار Co-Design Bench، الذي طوّره باحثون من Alibaba وجامعات آسيوية اعتماداً على طلبات تغيير حقيقية لتطبيقات ويب، أن GPT-6 Astra، الأفضل بين 10 نماذج، ينجز بالكامل 26.4% فقط من المهام، رغم تلبيته نحو 70% من متطلباتها في المتوسط.
يختبر المعيار تعديلات تشمل التصميم والتفاعل والمحتوى ومدخلات مثل الصور والفيديو والوثائق، مع تحقق صارم من عمل الميزات فعلياً. وتتراجع النتائج كلما اجتمعت أنواع تغييرات أكثر، بينما قد تتجاوز النماذج 99% في اختبارات أقدم. كما أثّر بيئة تشغيل الوكيل في النتائج، ما يدعم تقييم النموذج والأداة معاً.
AI coding agents still need human cleanup on nearly three out of four tasks in a real-world test · تاريخ النشر في المصدر: