
اختبار Taste-Bench يكشف ضعف وكلاء الذكاء الاصطناعي في القرارات طويلة الأمد
طوّر باحثون من Microsoft وجامعة City University of Hong Kong معيار Taste-Bench لقياس جودة اختيارات وكلاء الذكاء الاصطناعي أثناء المهام متعددة الخطوات. يضم المعيار 502 سؤالاً عند «نقاط تفرع» بين مسارين، ويفحص قدرة النموذج على اختيار الاتجاه الذي سيثبت لاحقاً أنه الأفضل.
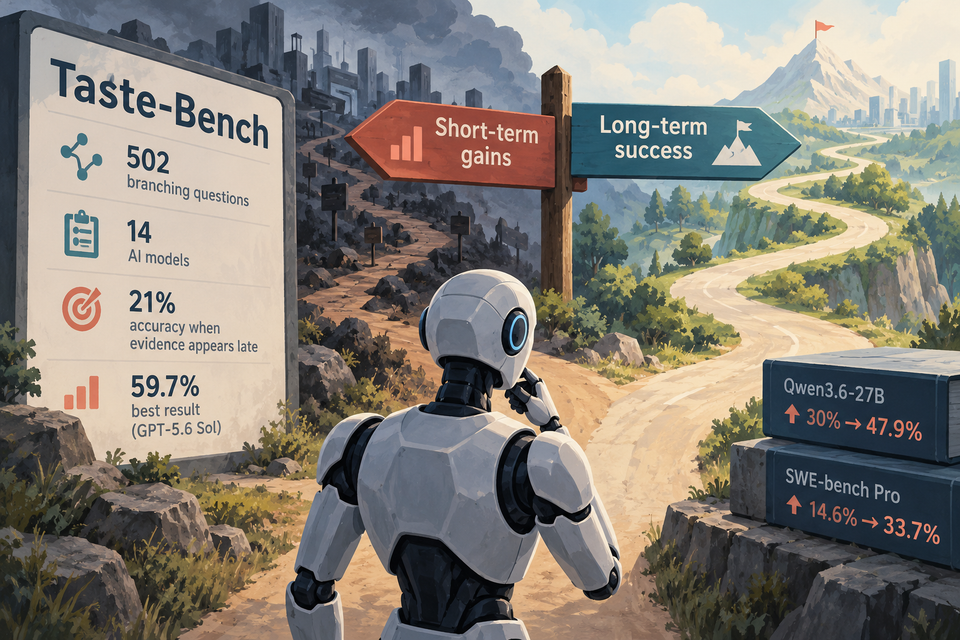
طوّر باحثون من Microsoft وجامعة City University of Hong Kong معيار Taste-Bench لقياس جودة اختيارات وكلاء الذكاء الاصطناعي أثناء المهام متعددة الخطوات. يضم المعيار 502 سؤالاً عند «نقاط تفرع» بين مسارين، ويفحص قدرة النموذج على اختيار الاتجاه الذي سيثبت لاحقاً أنه الأفضل.
اختُبر 14 نموذجاً، وحقق GPT-5.6 Sol أفضل نتيجة بلغت 59.7%، فيما هبط متوسط الدقة إلى 21% عندما لا تظهر الأدلة الحاسمة إلا بعد عمل لاحق طويل. ورفع تدريب نموذج Qwen3.6-27B دقته من 30% إلى 47.9%، وساعد وكلاء منفصلين على رفع نجاحهم في 41 مهمة SWE-bench Pro من 14.6% إلى 33.7%.
AI agents have bad taste in long-term decisions and a new benchmark proves it · تاريخ النشر في المصدر: