
CUDA 13.4 يدعم تقاسم وحدات GPU بحدود ذاكرة مُلزمة في Kubernetes
قدمت NVIDIA في CUDA 13.4 آلية لفرض حدود ذاكرة لكل حمل عمل على وحدات GPU داخل Kubernetes. ويشغّل GPU Fractioning Operator مفتوح المصدر خدمة MPS ويطبق الحدود وأنماط الحوسبة، فيما يدمج KAI Scheduler v0.18.0 وضع NvFractions لتحديدها لكل حاوية.
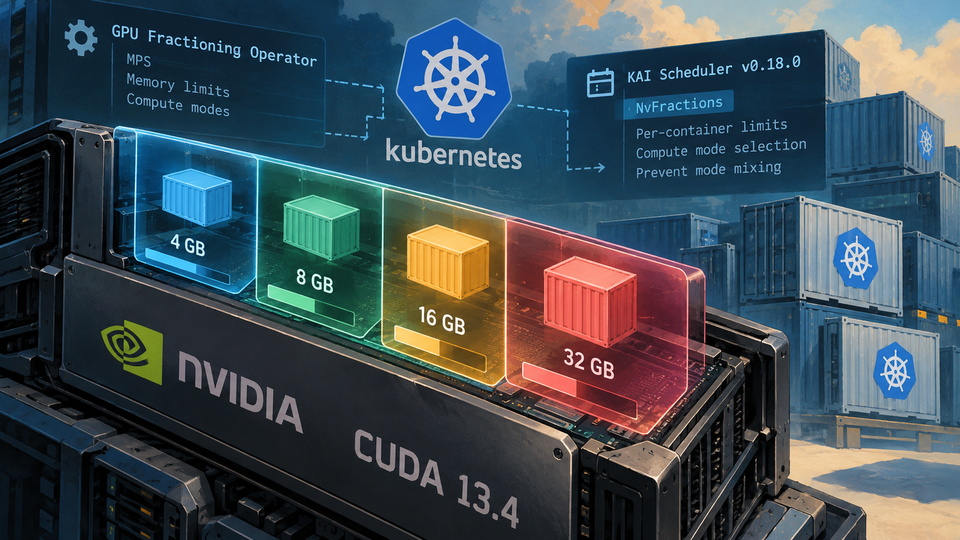
قدمت NVIDIA في CUDA 13.4 آلية لفرض حدود ذاكرة لكل حمل عمل على وحدات GPU داخل Kubernetes. ويشغّل GPU Fractioning Operator مفتوح المصدر خدمة MPS ويطبق الحدود وأنماط الحوسبة، فيما يدمج KAI Scheduler v0.18.0 وضع NvFractions لتحديدها لكل حاوية.
تتيح الآلية تخصيص ذاكرة دقيقة أو حد أدنى مضمون مع حد أقصى قابل للتمدد، واختيار تقاسم الحوسبة بين التقطيع الزمني وSM-sharing. وقد تساعد على رفع استغلال البنية التحتية، إذ إن كثيراً من أعباء الذكاء الاصطناعي لا تحتاج إلى وحدة GPU كاملة، مع إبقاء اختيار الوحدات ومنع خلط أنماط الحوسبة من مهام المجدول.
Memory-Enforced GPU Sharing in Kubernetes with NVIDIA CUDA 13.4 · تاريخ النشر في المصدر: