
CloudOpsBench يكشف أن الاستدلال أكبر عقبة أمام وكلاء الذكاء الاصطناعي السحابيين
أُطلق معيار CloudOpsBench المفتوح المصدر لقياس أداء وكلاء الذكاء الاصطناعي في مهام DevOps السحابية. تضم نسخته 1.0، التي أعدها مهندسو DevOps، 45 مهمة على AWS تشمل إصلاح الخدمات وإدارة الصلاحيات والتحديثات وإيقاف المشاريع.
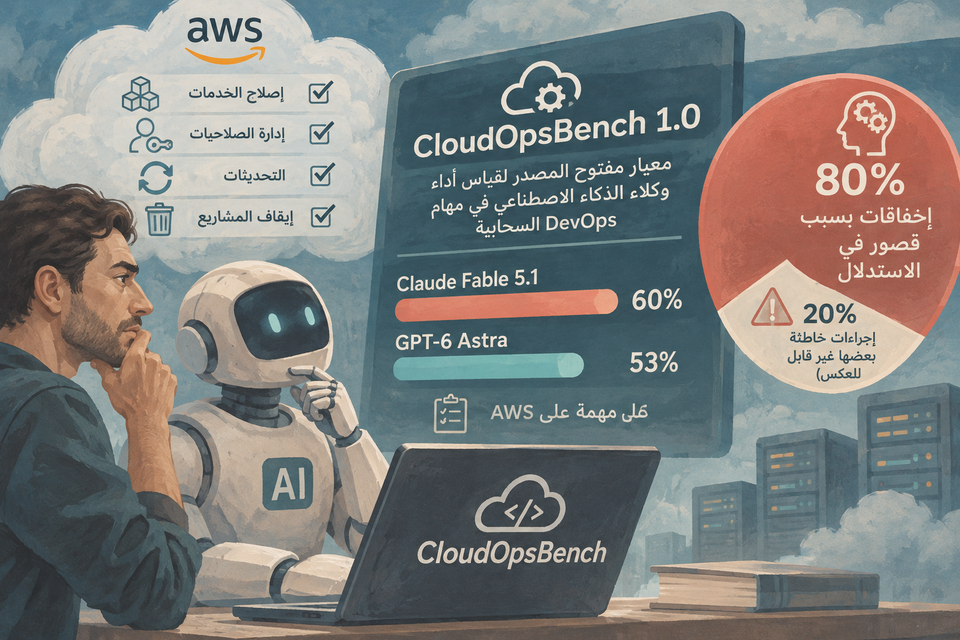
أُطلق معيار CloudOpsBench المفتوح المصدر لقياس أداء وكلاء الذكاء الاصطناعي في مهام DevOps السحابية. تضم نسخته 1.0، التي أعدها مهندسو DevOps، 45 مهمة على AWS تشمل إصلاح الخدمات وإدارة الصلاحيات والتحديثات وإيقاف المشاريع.
حل Claude Fable 5.1 نسبة 60% من المهام، مقابل 53% لـGPT-6 Astra. وقال فريق بقيادة أنغ تشن من جامعة ميشيغان إن نحو 80% من الإخفاقات تعود إلى قصور في الاستدلال، مثل سوء تقدير نطاق المهمة أو التوقف مبكرا، فيما تمثل الإجراءات الخاطئة، وبعضها غير قابل للعكس، نحو 20%.
New open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operations · تاريخ النشر في المصدر: