
بحث لـOpenAI: خيارات التدريب تقلّص شفافية نماذج الذكاء الاصطناعي
خلص تحليل لفريق السلامة في OpenAI إلى أن نماذج مثل GPT-6 Astra باتت أقل قابلية لمراقبة سلاسل التفكير. وعزا ذلك إلى تحسن النموذج الأساسي، وخيارات البنية، والتعلم المعزز، ونقل خصائص نماذج «المعلّم» إلى نماذج لاحقة.
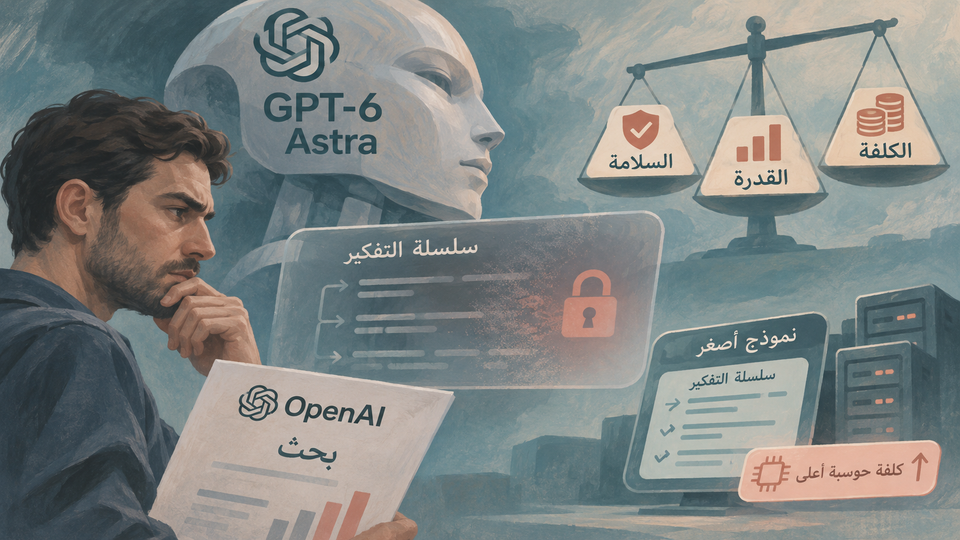
خلص تحليل لفريق السلامة في OpenAI إلى أن نماذج مثل GPT-6 Astra باتت أقل قابلية لمراقبة سلاسل التفكير. وعزا ذلك إلى تحسن النموذج الأساسي، وخيارات البنية، والتعلم المعزز، ونقل خصائص نماذج «المعلّم» إلى نماذج لاحقة.
تشير النتائج إلى أن تراجع الشفافية ليس نتيجة حتمية، بل مفاضلة بين السلامة والقدرة والكلفة. فالنماذج الأصغر التي تعرض تفكيرها كتابةً قد تضاهي نماذج أكبر في بعض الاستخدامات، لكنها تتطلب كلفة حوسبة أعلى بسبب سلاسل التفكير الأطول. وقالت OpenAI إن الحاجة ملحّة لأساليب مراقبة تتجاوز قراءة هذه السلاسل.
OpenAI’s data suggests that frontier models are hiding their thoughts because developers optimize for capability and compute · تاريخ النشر في المصدر: