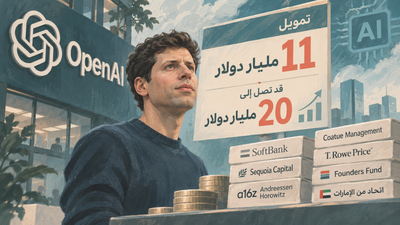
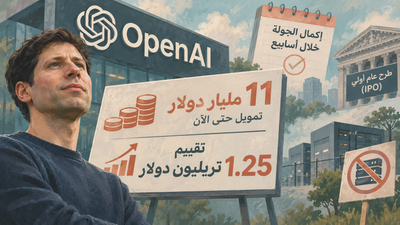
حصلت OpenAI على نحو 11 مليار دولار كدفعة أولى من جولة تمويل تُقيّم الشركة عند 1.25 تريليون دولار، وحُوّلت الأموال الجمعة. وقد تصل قيمة الجولة إلى 20 مليار دولار خلال الأسابيع المقبلة.
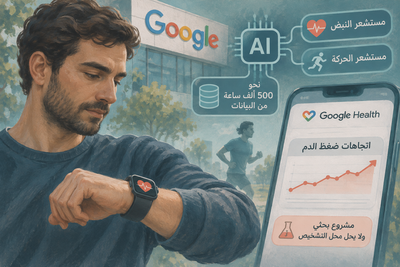
طوّر باحثون في Google نظام ذكاء اصطناعي يرصد مؤشرات ارتفاع ضغط الدم عبر ساعة ذكية عادية من دون سوار قياس أو معايرة. ويعتمد على مستشعري النبض والحركة، وتعلّم من نحو 500 ألف ساعة من بيانات المستشعرات.
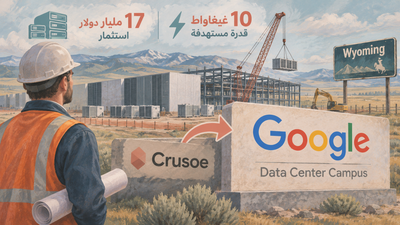
أكدت Crusoe بيع مشروع مركز بيانات غير مكتمل في جنوب شرقي وايومنغ إلى Google، التي ستتولى تطويره بعد تعثر مساعي Crusoe لجذبها عميلاً للمشروع. ولم تكشف Google قيمة الصفقة، لكنها تعتزم استثمار 17 مليار دولار في حرم مركز البيانات.
يُقال إن OpenAI جمعت 11 مليار دولار حتى الآن ضمن جولة تمويل جديدة تقيّم مختبر الذكاء الاصطناعي عند 1.25 تريليون دولار. ولم تُغلق الجولة بعد، ومن المتوقع إتمامها خلال أسابيع بقيمة إجمالية تقارب 20 مليار دولار.
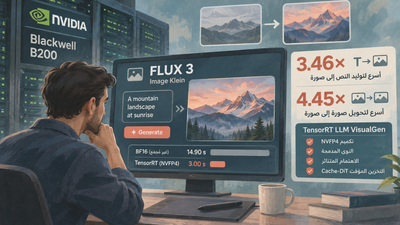
قالت NVIDIA إن TensorRT LLM VisualGen سرّع تشغيل FLUX 3 Image Klein على معالج B200 واحد، محققاً حتى 3.46 مرات أسرع لتوليد النص إلى صورة و4.45 مرات لتحويل صورة إلى صورة عند دقة 2048×2048، مقارنة بتشغيل BF16 غير المُجمّع.
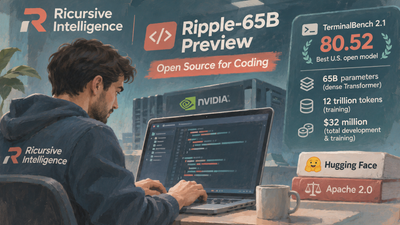
أعلنت شركة Ricursive Intelligence، المتخصصة في تصميم رقائق الذكاء الاصطناعي، نموذج اللغة المفتوح Ripple-65B Preview بعد تدريبه على 12 تريليون رمز. وقالت الشركة إنه حقق 80.52 في معيار TerminalBench 2.1 للبرمجة، كأفضل نتيجة لنموذج أميركي مفتوح.
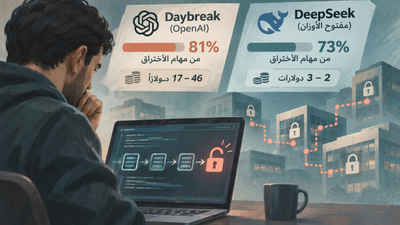
أظهرت اختبارات على شبكات شركات وهمية أن نموذج Daybreak من OpenAI أنجز 81% من مهام الاختراق، مقابل 73% لنموذج DeepSeek الصيني مفتوح الأوزان. وتساوى النموذجان في بعض المهام، فيما شملت الاختبارات اختراق شبكات متعددة المراحل.
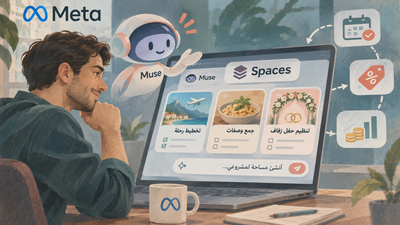
أطلقت Meta ميزة Spaces ضمن واجهة وكلاء Muse، لتتيح إنشاء مساحات منفصلة لمشاريع وموضوعات محددة. ويمكن للمستخدم وصف الفكرة في الدردشة ليبني Muse مساحة على هيئة متعقب أو مخطط أو لوحة مشروع، مثل تخطيط رحلة أو جمع وصفات أو تنظيم حفل زفاف.
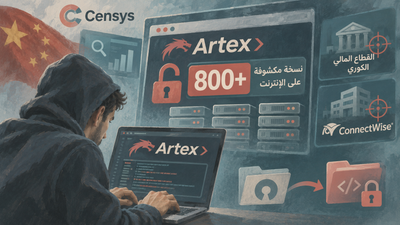
رصدت شركة Censys أكثر من 800 نسخة من أداة الاختبار الاختراقي المعتمدة على الذكاء الاصطناعي Artex متاحة علناً عبر الإنترنت من دون كلمات مرور. والأداة صينية المنشأ ومفتوحة المصدر، وقد ارتبطت بهجمات سيبرانية منذ إطلاقها في يوليو.
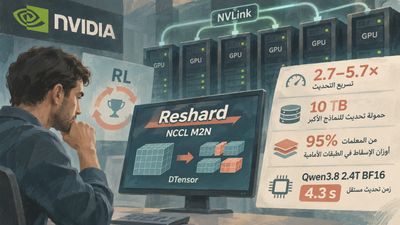
أعلنت NVIDIA أن تقنية Reshard ضمن NCCL M2N تقلّص نقل البيانات عند تحديث أوزان نماذج الاستدلال من وحدات تدريب GPU خلال ما بعد تدريب التعلم المعزز. وحققت في اختبارات NeMo RL تسريعاً بين 2.7 و5.7 مرات مقارنة بأسلوب الجمع ثم البث.